7. 爬虫治理
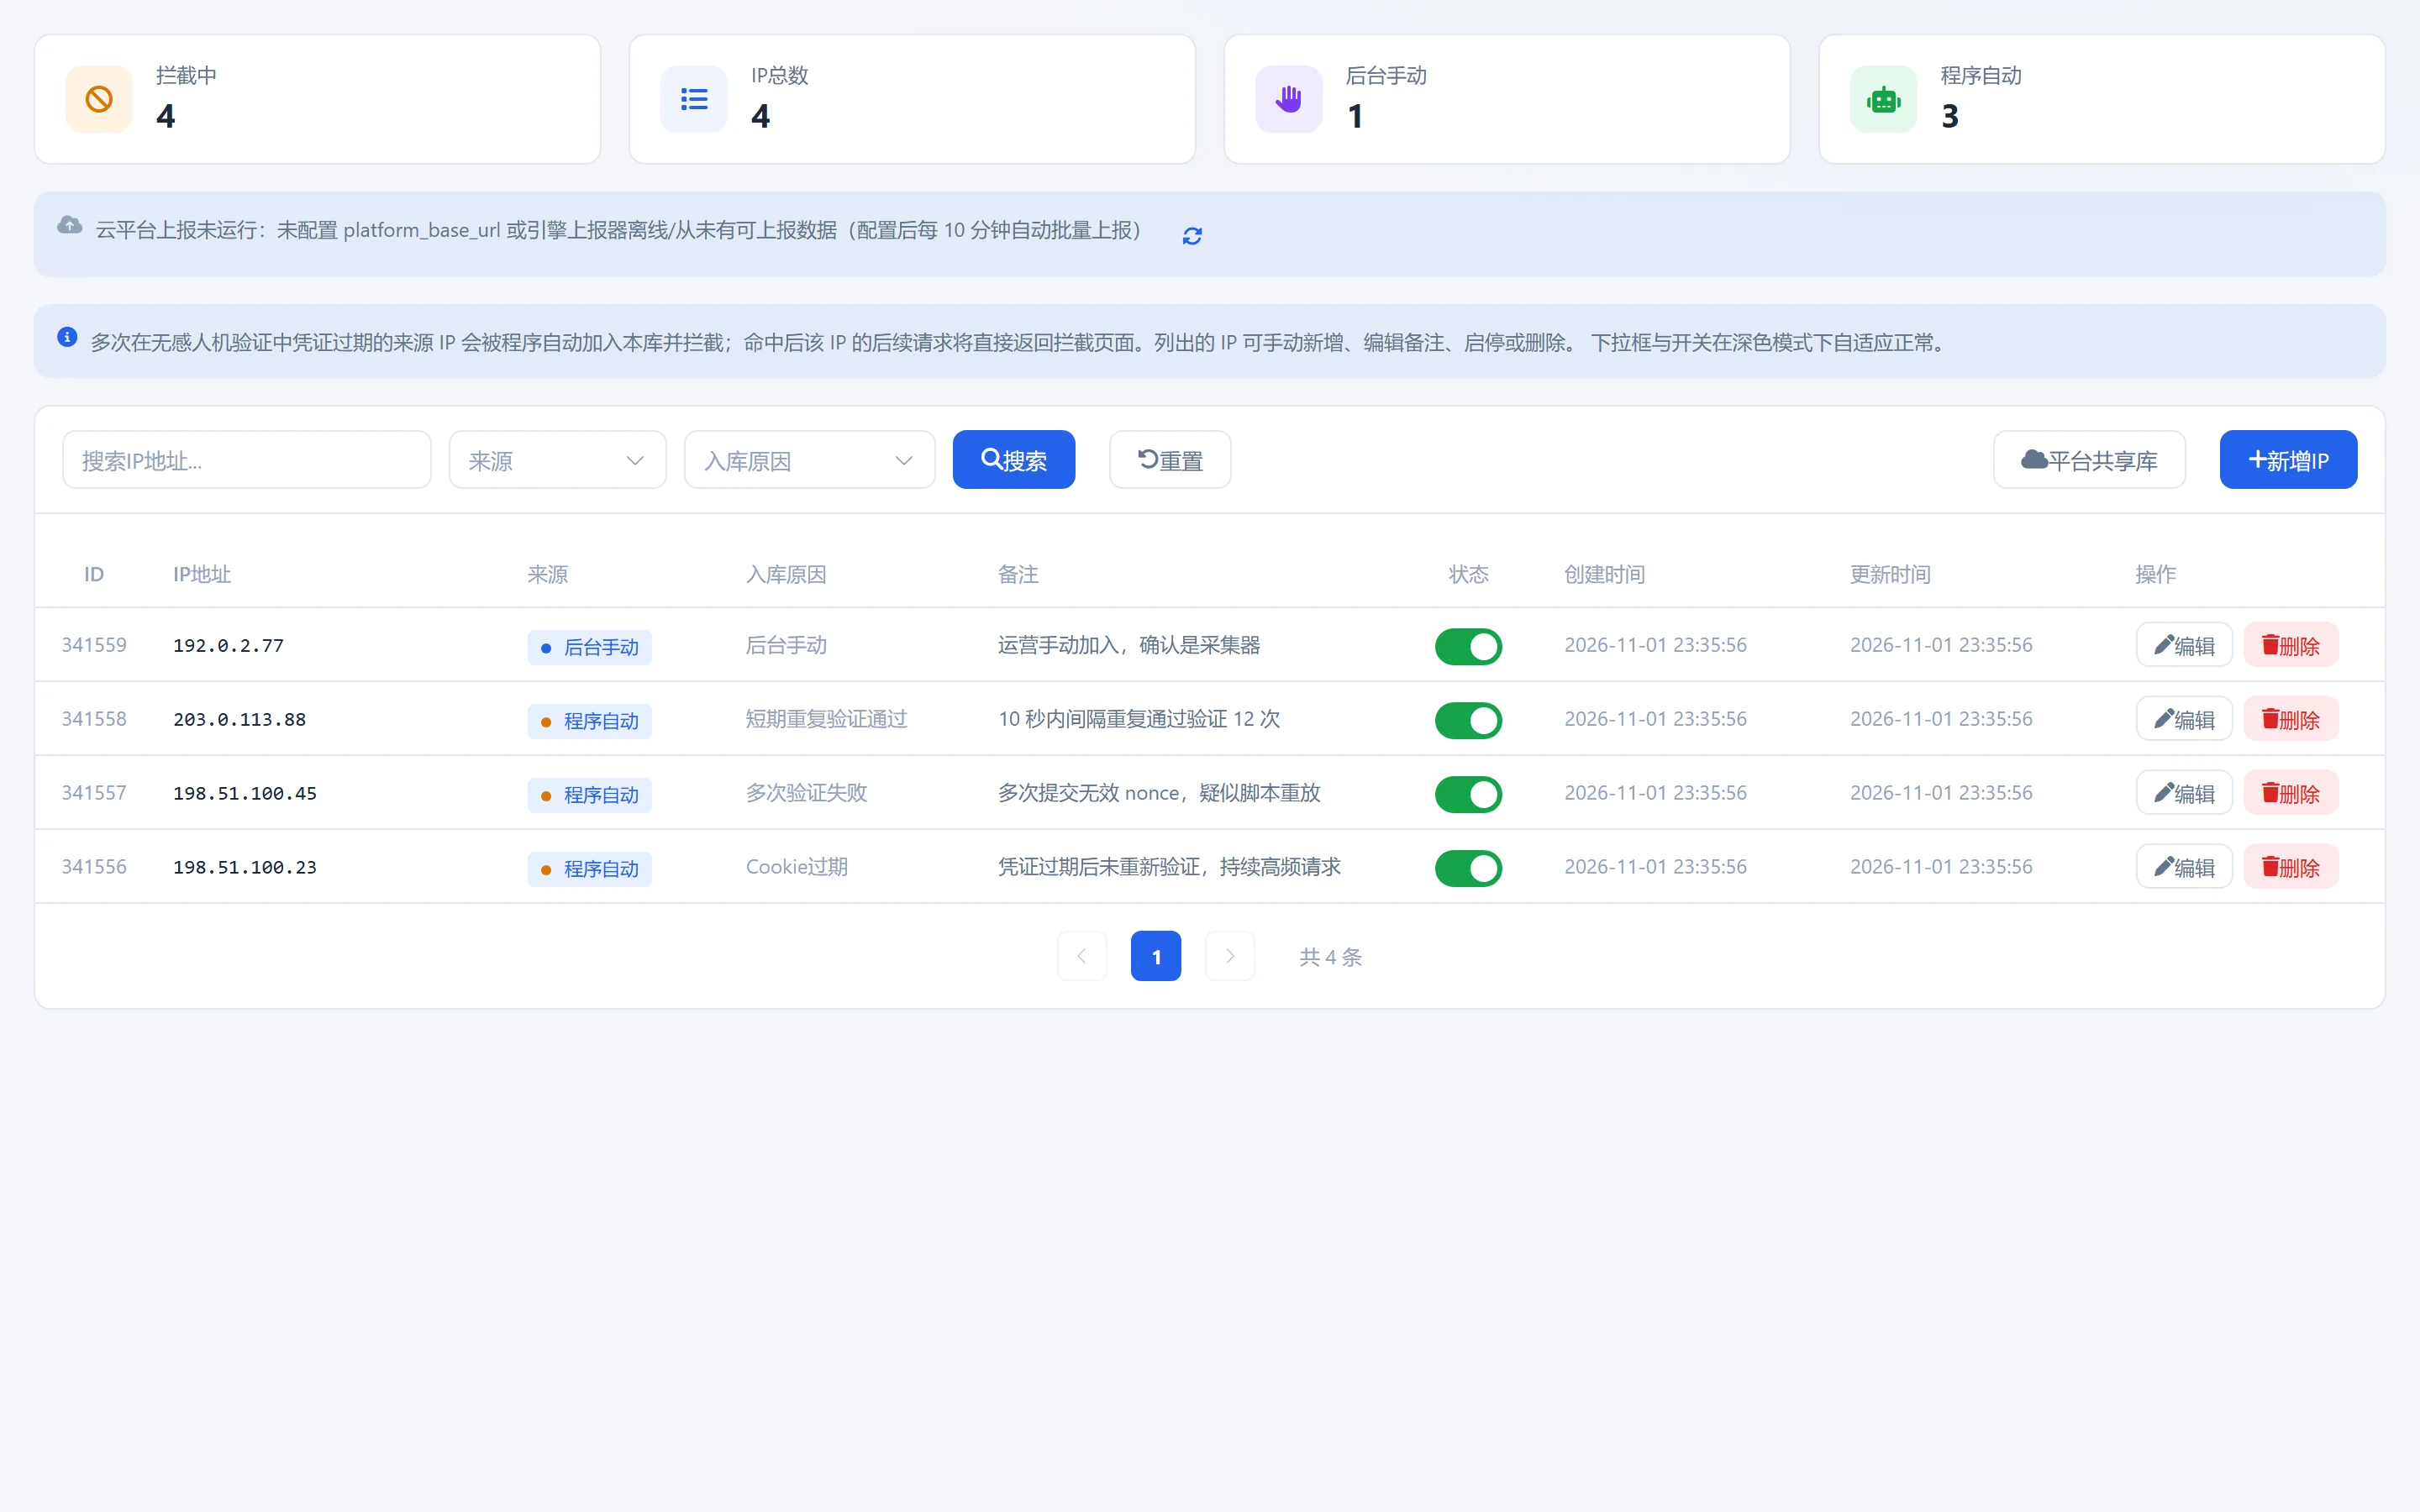
「防护规则 → 爬虫IP库」背后是两套完全不同性质的数据,混为一谈会出事故:一套拦恶意脚本,一套识别并保护真蜘蛛。
7.1 恶意爬虫 IP 库(黑名单)
来源是引擎在防护过程中实锤的脚本行为,不是猜测。入库原因有九种:
| 入库原因 | 什么行为触发 |
|---|---|
| Cookie 过期 | 用过期凭证反复访问验证接口 |
| 短期重复验证通过 | 短时间内高频「通过验证」,人不可能这么快 |
| 多次验证失败 | 单会话静默 3 次 / 交互 5 次用满 |
| 短时错误频繁 | 短时间大量异常请求 |
| 资源请求不完整 | 验证页的必需静态资源没按预期加载(无头浏览器典型特征) |
| 失败围栏 | 60 秒窗口内「不像人」的失败 ≥5 次且 0 成功 |
| 无 JS 执行 | 完全不执行 JS 的客户端 |
| 指纹头矛盾 | UA 声称是 Chrome 但 Sec-CH-UA 等指纹对不上 |
| 后台手动 | 你自己在后台手工添加的 |
三个必须知道的行为特征
- 命中即拦,且不会自动解除。 这是有意的:被这套机制实锤的来源,没有「观察一阵子再说」的价值。误拦了才需要人工处理。
- 入库有延迟是正常的。 引擎本地先在内存里拦截,批量落库(攒 5 秒或 100 条),后台列表晚几秒出现是预期行为,不是丢了。
- 解除只有两个途径:列表里手动删除该 IP,或把该条禁用(
status=0,保留记录不再拦截)。没有自动解封时间——如果你期望「封 30 分钟自动放出来」,那是 CC 的行为,不是爬虫库的。
误拦处理流程
- 攻击日志 / 业务反馈确认被拦 IP
- 到爬虫 IP 库搜该 IP,看入库原因
- 判断是真是误:
- 入库原因是「Cookie 过期」「多次验证失败」,且该 IP 属于办公网/合作方 → 加白名单跳过验证,然后删库记录
- 入库原因是「资源请求不完整」「指纹头矛盾」 → 99% 是真脚本,别删
- 治本:把误拦来源做成白名单(按 IP 组),下次不会再入库
7.2 搜索引擎蜘蛛 IP 库(基准库,白名单性质)
SEO 是命根子,但搜索引擎的爬虫也分真假:伪装成 Baiduspider 的脚本满大街。畅来WAF 的做法不是「看到蜘蛛 UA 就放行」(那等于给所有脚本开后门),而是 rDNS 金标准回验:
请求 UA 命中搜索引擎特征
  ↓
对来源 IP 做 PTR 反向解析
  ↓
反解域名匹配该引擎官方后缀(如 *.baidu.com / *.googlebot.com)
  ↓
对反解结果做正向解析,确认 IP 回得来(防伪造 PTR)
  ↓
三步全过 → 认定为真蜘蛛,按 IP 段归档| 项 | 说明 |
|---|---|
| 支持的引擎 | 百度 / 必应 / 360 / 搜狗 / 神马 / Google / Petal / Apple / Yandex / DuckDuckGo,共 10 家 |
| 数据形态 | 引擎把确认的真蜘蛛 IP 无损聚合成 IP 段,每日增量上报云平台 |
| 云平台侧 | 区间并集合并成最简 CIDR,去重后沉淀为全网共享的蜘蛛基准库 |
| 用途 | 确认真蜘蛛;配合白名单「跳过验证 / 跳过 CC」让蜘蛛顺畅抓取;未被回验证实的「假蜘蛛」照常吃完整防护链 |
常见误区:担心蜘蛛被 WAF 拦掉影响收录。真蜘蛛(rDNS 三步全过)不会被当恶意爬虫入库;会拦的是伪造蜘蛛 UA 的脚本——它们被拦恰好保护了你的 SEO 环境。
7.3 云共享爬虫库 [Pro]
单个引擎看到的攻击者有限,共享库把全网实例的实锤数据汇起来:
- 各实例把高置信度入库的 IP(Cookie 过期 / 资源不完整 / 失败围栏等类别)每 10 分钟批量上报云平台
- 云平台按
(IP, 原因, 时间)幂等去重,统计有多少独立实例上报过同一 IP - 同一 IP 被达到聚合阈值(默认 3 个实例)以上上报 → 进入共享库
- 共享库按版本下发到各引擎:免费版取种子 Top100,Pro 全量
- 已确认整改的 IP 会被移出(tombstone 机制),上报日志保留 30 天可审计
你的业务数据不参与共享。 上报内容只有 IP + 入库原因 + 时间戳,没有 URI、没有 UA、没有业务请求信息。
下一步:8. 观测与排障

